
让记忆成为模型能力 记忆张量发布并开源MemT 1.0
10 月 20 日,记忆张量(MemTensor)正式发布并开源记忆原生基础模型 MemT 1.0 系列,包含 MemT-1.0-Flash 与 MemT-1.0-Nano 两款模型。该系列模型在 11 项记忆基准上位列同类方法第一、第二;在长历史场景下,端到端推理提速最高近 4 倍,持久化存储较传统完整上下文方案缩减约 130 倍。
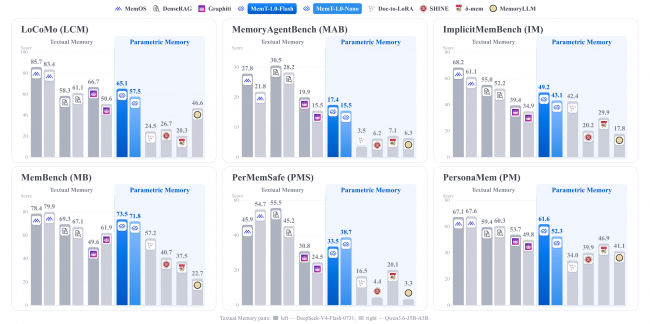
图:MemT 1.0 在基准测试中的记忆性能表现
不同于依赖长上下文的既有路线,MemT 1.0 把可持续更新的内部记忆纳入模型计算:历史信息与任务经验写入记忆状态,后续任务可直接调用,无需再次提供原始历史文本。
传统方案处理长会话,靠的是把越来越长的历史文本一直带在模型上下文里,聊得越久、成本越高。MemT1.0 的思路是让模型自己“记笔记”:在模型内部加入可训练的记忆模块,每轮交互结束后自动把新信息整理进固定大小的记忆,之后需要时直接“想起来”,而不是每次重新翻记录。模型在 340 亿 token 的训练语料上分两阶段训练:先学会把信息写进记忆,再学会根据记忆回答问题。
记忆领先,长历史更快
在 11 项记忆基准上,MemT-1.0-Flash 平均得分 50.6,MemT-1.0-Nano 为 47.0,位列本次评估的参数化记忆方法第一、第二,比同类方法最高平均分分别高出 12.5 分、8.9 分;平均表现上与检索增强方案基本持平,且无需在每次查询时现场检索历史资料。同时,挂载记忆并不影响模型通用能力:在干扰信息较多的评测条件下,Flash 的通用能力与挂载记忆前基本持平,部分基准还有提升。
效率上,历史越长优势越明显:128K 历史下端到端推理提速约 1.86 倍,256K 下约 3.99 倍;查询首字延迟稳定在约 104—112 毫秒,而传统完整上下文方案在 256K 历史下要约 445 毫秒。存储上,256K 历史下每条会话的记忆状态约 40 MiB,较传统方案约 5.06 GiB 缩减约 130 倍。上述优势在长会话、长历史场景最为明显。
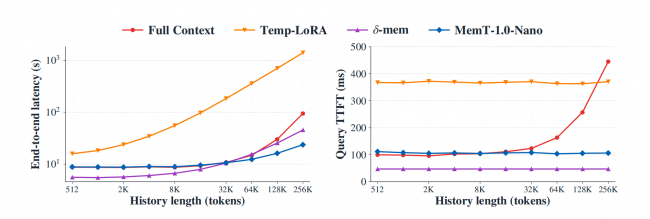
图:每条交互轨迹的持久化存储占用结果
省成本、可复用、能学习
对开发者而言,记忆原生带来的价值可以落在三个层面。一是省成本:长会话不再需要把整段历史反复塞进上下文,推理开销与响应延迟更可预期,尤其适合客服、办公助手等高频长会话场景。二是体验更稳:历史再长,查询首字响应时间也基本保持不变,用户不会“越聊越卡”。三是能力能成长,记忆的保留、更新与调用都由模型在训练中学会,随着交互积累,模型可以真正“记住”经验并在后续任务中复用,为持续学习与自我进化打下基础。
大模型能力新增长路径
过去,大模型能力主要靠参数、数据与上下文三条路径增长;MemT 1.0 让“有效经历”成为可复用资产,开辟新路径。在编程智能体实测中,把历史解题经验写入模型记忆后,MemT-1.0-Nano 在 SWE-bench Verified(500 项任务)上平均成功率由 66.07% 提升至 69.73%,三次全部成功的任务比例由 54.00% 升至 62.80%;在覆盖九种语言的 SWE-bench Multilingual(300 项任务)上,平均成功率由 60.00% 升至 63.56%。这些能力将直接惠及软件研发、智能客服、个性化服务等强交互场景:智能助手记住用户偏好,客服无需用户反复说明背景,编程助手沉淀调试经验、越用越顺手。
从“会推理”走向“会积累”
研发团队表示,后续将提升长期记忆、扩展记忆容量、降低记忆更新成本,逐步迈向能够从交互中持续学习、通过记忆不断进化的智能体,让记忆原生为持续学习及递归自我改进(RSI)提供基础。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”