物理世界模型的Scaling Law:真正稀缺的不是机器人,而是可规模化的物理数据
当 AI 从数字世界走向物理世界,模型面对的将不再只是“回答错了能不能重新生成”“代码写错了能不能回滚”。一旦 AI 开始驾驶车辆、操作机械设备、参与生产,甚至进入家庭,错误就可能直接转化为现实世界中的安全风险和经济损失。
数字世界允许先行动、再纠错,而物理世界更需要在行动之前进行预测和推演。因此,具身智能要真正进入现实世界,仅仅拥有一个更大的模型可能还不够,它还需要形成对物理世界的预测能力,并在真实环境中通过反馈不断修正。
这正是物理世界模型试图解决的问题。
9月17日,在星连资本联合 AI 蓝鲸汇、未来边际举办的“世界模型的未来与展望”活动上,清华大学自动化系副教授、博士生导师、系统工程研究所副所长封硕围绕《物理世界模型的 Scaling Law》进行了分享。
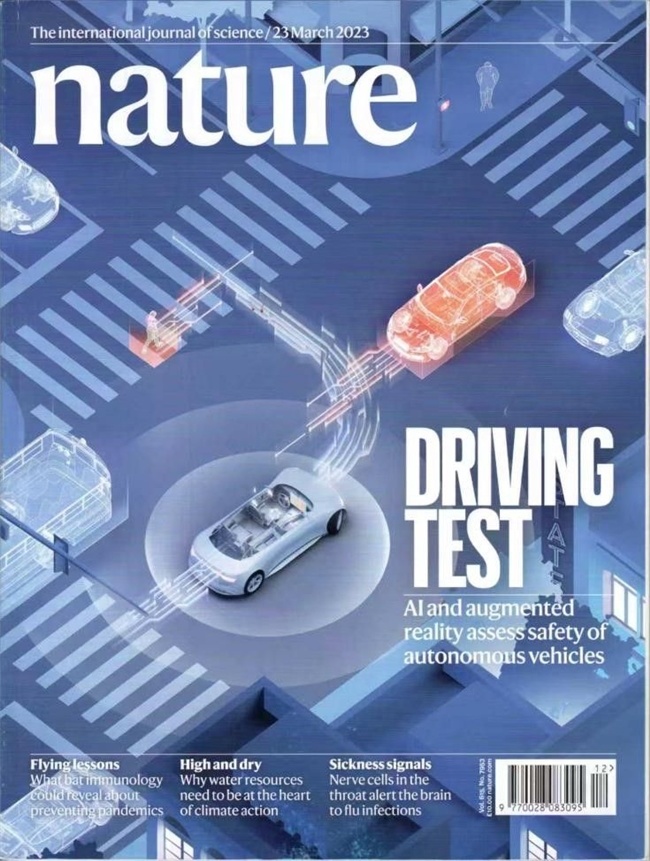
作为长期深耕物理AI领域的青年学者,封硕曾于2023年以独立第一作者身份在《Nature》正刊发表物理AI相关封面论文,先后获得MIT TR35、达摩院青橙奖、世界人工智能大会云帆奖、智源青年学者等荣誉,并于2026年入选国家自然科学基金青年科学基金项目A类(原国家杰出青年科学基金项目)。这些研究经历,也构成了他持续探索物理世界模型及其Scaling规律的学术基础。
与当下不少围绕模型参数、架构和本体展开的讨论相比,他把问题进一步向前追问了一步:如果物理世界模型要真正实现 Scaling,它最先需要解决的究竟是什么?
封硕给出的答案是:数据。
机器人不能像人一样,在现实世界里“长大二十年”
人类认识物理世界,并不完全依赖直接行动。
比如走到一条河边,人通常不会先计算完整的流体方程,而是通过观察水流、深浅、河床和落脚点,对下一步行动形成判断。真正踏入水中后,身体获得的反馈又会进一步修正原来的判断。
从感知、预测,到行动,再到反馈,人类实际上一直在维护一个关于外部世界的内部模型。
世界模型的思想也并非最近才出现。1943年,英国心理学家肯尼斯·克雷克就提出,如果有机体在头脑中拥有一个外部现实的“小尺度模型”,就可以在面对紧急情况之前,预先试验不同可能性。后来,控制理论中的内模原理,以及深度学习领域的 World Models 等研究,都推动了这一思想的发展。
但物理世界与围棋、游戏等数字环境存在根本差异。游戏中的错误可以重来,环境可以反复 reset;物理世界却不会因为机器人的一次错误而重新开始。设备存在成本,动作可能造成损坏甚至安全事故。
封硕认为,人可以花二十年在真实世界中成长、试错和积累经验,但机器人等不了这么久。
因此,机器人需要在真正行动之前,通过世界模型进行“间接实践”,先在内部预测可能发生什么,再进入真实环境行动,并利用真实反馈不断修正。
大语言模型继续变大,能否绕开世界模型?
随着大语言模型和多模态模型能力不断提升,一个自然的问题也随之出现:如果模型继续扩大参数规模、增加训练数据和算力,能否直接获得足够强的物理理解能力?
封硕并没有否定这种可能性。模型可以把物理问题转化为数据、程序或仿真问题,也可以利用更多算力进行推演;视频模型同样可能从大量视觉数据中学习部分物理规律。
但问题在于效率。
如果模型需要不断经过文本、图像、视频、符号和程序等不同层次,才能间接理解物理世界,那么它或许能够得到答案,但距离物理规律本身仍然存在距离。
人类的很多物理判断则来自长期形成的“物理直觉”。拿杯子、踩台阶、推开一扇门时,人不会每次都重新计算完整的物理过程,而是依靠内部形成的经验模型预测行动后果,并在行动之后利用反馈修正。
因此,在封硕的设想中,未来智能可能由不同能力协同完成:通用认知模型负责理解目标、组织知识和长程推理,物理世界模型则负责物理直觉、变化预测和行动反馈。
而这最终又回到了一个更基础的问题:这样的模型拿什么训练?
真正稀缺的,不是机器人,而是可 Scale 的物理数据
算力、算法和数据,是解释 AI 能力增长最常见的三个变量。
互联网时代,大量文本、代码、图片和视频自然沉淀,为大模型提供了海量训练材料。算力也可以随着硬件发展不断提升,算法则持续迭代。
但物理世界的数据不会自己堆起来。
采集一份物理数据,往往需要真实设备、真实场景、人员和时间,还伴随着设备磨损和失败成本。因此,封硕认为,当前具身智能和物理世界模型真正的核心瓶颈,是数据规模。
这也解释了为什么具身智能很难直接复制自动驾驶的数据飞轮。
自动驾驶领域,一种路径是依靠专用车辆和测试体系持续采集数据,质量相对可控,但车辆、里程和地域都受到成本约束;另一种路径则依托量产车辆,让用户日常使用过程中自然产生数据,数据获取的边际成本更低。
机器人面临的问题更加突出。一辆没有高级智能驾驶能力的汽车,仍然可以作为交通工具被用户购买和使用;但一台没有足够智能的机器人,很多时候很难稳定完成任务,也就更难通过规模化销售进入真实场景。
于是形成了一个冷启动循环:没有足够机器人,就没有规模数据;没有规模数据,模型能力就难提升;模型能力不足,又限制机器人进入更多场景。
这意味着,物理世界模型的产业化问题,首先不是“再造多少台机器人”,而是寻找能够持续产生真实物理数据的场景。
这也是 DenseAI(幂级智能)成立的重要出发点:把世界模型带入真实产业场景,从已有真实业务中寻找可持续产生物理数据的入口,让场景、数据与模型形成长期闭环。
Scaling 的起点,需要从“本体”转向“数据”
因此,封硕提出了一个与传统路径不同的顺序:先做数据,再做模型,最后赋能本体。
这并不是说机器人本体不重要,而是意味着在早期阶段,更需要优先解决的是数据源。
什么样的数据,才可能成为物理世界模型长期 Scaling 的燃料?
首先,边际成本要足够低,最好接近于零。一个关键问题是:如果不做世界模型,这些数据会不会也自然产生?如果车辆本身就在真实道路上行驶,那么行驶过程中产生的数据,就不需要完全由 AI 项目额外承担采集成本。
其次,数据需要包含真实的物理信息。它不一定一开始就覆盖完整的触觉、力学和复杂交互,但至少应该记录空间关系、状态变化、物体运动,以及动作可能带来的结果。
第三,数据源需要从 Day 1 就具备扩展能力。项目一开始就需要考虑,这条路径能不能从现在的规模扩大一万倍、十万倍。
封硕将这三个条件概括为:边际成本、物理含量和 Day 1 可扩展性。缺少其中任何一个条件,都可能成为未来规模化的瓶颈。
对于 DenseAI 而言,真正值得寻找的是一类能够持续产生数据、能够随着业务规模自然扩张的真实场景。场景本身成为数据入口,数据进一步成为模型迭代的燃料,模型能力提升后再反过来赋能场景。
这样的闭环一旦成立,Scaling 才不再只是模型参数的扩大,而可能成为真实世界中数据、模型和应用共同增长的过程。
从 Demo 到 Scale,第一天就要考虑规模化
过去几年,具身智能领域出现了大量令人印象深刻的 Demo,但可演示并不等于可部署,更不等于可规模化。
在特定场景中,通过高精地图、人工规则或者场景设计,可以让系统获得较好的表现。但当环境进入开放世界,长尾情况和成本会迅速增加。
因此,在 AI 技术快速迭代的时代,比“当前技术能不能做到”更重要的问题,是这条技术路线是否存在底层物理障碍。
对于物理世界模型而言,Scaling 不应该成为技术成熟之后才考虑的问题,而应该成为 Day 1 的设计约束。
数据、算法和算力都需要具备规模化能力:数据需要低边际成本并能够持续扩展,算法需要能够持续吸收低成本数据并快速迭代,算力则建立在硬件和能源持续发展的基础之上。
归根结底,物理世界模型的 Scaling Law 需要回答三个问题:
数据从哪里来?成本由谁承担?规模如何持续扩大?
如果能够找到一条持续产生真实物理数据的路径,算法可以继续迭代,算力可以持续增加,模型能力也就有了 Scaling 的基础。
因此,在封硕看来,物理世界模型真正的机会,可能不是简单地制造更多机器人,而是找到一个能够以接近零的边际成本、持续产生真实物理数据的数据源。
先让数据规模化,再让模型规模化,最终让智能进入更多真实世界。
这或许是物理世界模型从 Demo 走向规模化落地之前,需要回答的第一个问题。也是 DenseAI长期探索的问题。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”